Современные программные системы характеризуются высокой сложностью, распределённостью и необходимостью частых обновлений. Микросервисная архитектура стала доминирующим подходом к их построению, позволяя разделять систему на небольшие автономные сервисы, разрабатывать, тестировать и масштабировать их независимо друг от друга. Такой подход обеспечивает высокую скорость вывода новых функций, устойчивость к отказам отдельных компонентов и возможность использовать наиболее подходящие технологии для каждой бизнес-задачи 8.
Вместе с тем переход к микросервисам значительно усложняет управление системой. Увеличивается количество межсервисных взаимодействий, растёт сложность трассировки, согласованности данных и обеспечения наблюдаемости. Появляется технологическая неоднородность, усложняется контроль нагрузки и распределение функций между сервисами. Неправильная декомпозиция или избыточная связанность быстро приводят к архитектурной деградации, росту задержек, повышению числа инцидентов и увеличению эксплуатационных затрат 11.
Всё это делает задачу объективной оценки качества микросервисной архитектуры и поиска её оптимальной конфигурации одной из ключевых в современной программной инженерии. Требуется единый подход, позволяющий одновременно учитывать десятки разнородных показателей — от времени отклика и потребления ресурсов до структурной связанности, сопровождаемости и технологической совместимости — и преобразовывать их в понятную количественную характеристику эффективности 2.
Настоящая работа посвящена разработке информационной системы, которая автоматизирует процесс комплексной оценки и оптимизации микросервисных архитектур с использованием математического моделирования, интегральных критериев качества и современных методов многокритериальной оптимизации 1.
Микросервисная архитектура стремительно вытесняет монолитные и классические SOA-решения в большинстве крупных и средних компаний. По данным исследований CNCF за 2024–2025 годы более 85 % организаций, использующих контейнеризацию, применяют микросервисы в продакшене, а их количество в отдельных системах достигает сотен и тысяч независимых сервисов. При этом наблюдается парадокс: несмотря на очевидные преимущества в скорости разработки и масштабируемости, многие проекты сталкиваются с систематическим ухудшением ключевых эксплуатационных характеристик через 1–3 года после перехода на микросервисы 28.
Существующие методы оценки либо фрагментарны (анализируют отдельные метрики: latency, error rate, CPU), либо субъективны (экспертные аудиты, Architecture Fitness Functions в ограниченном объёме). Отсутствует единый количественный показатель, позволяющий:
Таким образом, разработка комплексного критерия качества микросервисной архитектуры и информационной системы для его расчёта и оптимизации является актуальной научно-практической задачей, решение которой позволит существенно снизить риски и затраты при проектировании, развитии и эксплуатации современных распределённых систем 1.
Цель работы — повышение эффективности и качества микросервисных архитектур за счёт разработки системы автоматизированного поиска их оптимальной конфигурации. Это обеспечивается на основе комплексной количественной оценки архитектурных решений с использованием методов математического моделирования и многокритериальной оптимизации.2.
Для достижения поставленной цели решаются следующие задачи:
Для поиска эффективной конфигурации микросервисных систем применяются следующие группы методов:
Все современные высокопроизводительные решения в области автоматической оптимизации микросервисов (Netflix Conductor, Uber Michelangelo, Alibaba Sigma) используют комбинацию перечисленных подходов, где эволюционные алгоритмы отвечают за глобальный поиск, суррогатные модели — за скорость, а RL — за онлайн-адаптацию 25.
Для визуализации охвата метрик были построены два ключевых графика. На рисунке 1 представлено распределение метрик по инструментам мониторинга, где явно выделяется Prometheus как центральный инструмент, покрывающий 15 метрик. На рисунке 2 показано распределение метрик по категориям, демонстрирующее преобладание операционных метрик (25,71%) над остальными категориями 16.
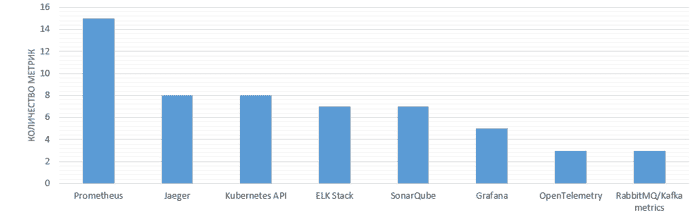
Рисунок 1 - Соотношение количества метрик к инструментам мониторинга
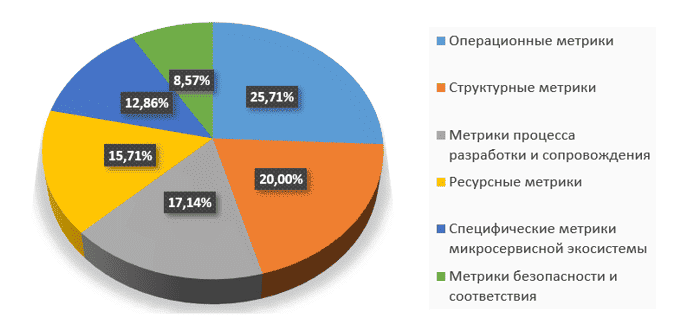
Рисунок 2 – Распределение метрик по категориям
На основе проведенного анализа выделены ключевые метрики для оптимизации микросервисной архитектуры и записаны в таблицу 1 26.
| Название метрики | Краткое описание | Единицы измерения | Способ замера / инструмент |
|---|---|---|---|
| Время отклика (Response Time) | Среднее время ответа сервиса на запрос | миллисекунды (мс) | Prometheus + Grafana, Jaeger, Apache JMeter 16 |
| Пропускная способность (Throughput) | Количество запросов, обработанных за единицу времени | запросов/сек (RPS) | Apache JMeter, k6, Locust 15 |
| Количество ошибок (Error Rate) | Отношение неуспешных запросов к общему числу | % | Prometheus, Grafana, ELK 16 |
| MTTR (Mean Time To Recovery) | Среднее время восстановления после сбоя | минуты, часы | Incident Management, Kibana |
| Утилизация CPU (CPU Utilization) | Доля использования процессорного времени | % | Prometheus (node_exporter), Kubernetes metrics 12 |
| Утилизация памяти (Memory Usage) | Используемый объём оперативной памяти | МБ, ГБ | Prometheus, cAdvisor |
| Связанность сервисов (Coupling Degree) | Среднее количество зависимостей между сервисами | ед. | Jaeger, Zipkin, архитектурный граф 8 |
| Число вызовов между сервисами (Inter-Service Calls) | Количество сетевых взаимодействий между сервисами | ед. | OpenTelemetry, Jaeger |
| № | Метод | Автоматизация | Скорость работы | Учёт динамики нагрузки | Многокритериальность | Сложность внедрения | Примеры инструментов |
|---|---|---|---|---|---|---|---|
| 1 | Экспертно-ориентированные | Низкая | Очень низкая | Нет | Частично (на глаз) | Низкая | DDD 3, Event Storming, Fitness Functions |
| 2 | Правило-ориентированные и статические | Высокая | Высокая | Нет | Ограниченно | Низкая | SonarQube 5, ArchUnit, NDepend, Service Cutter |
| 3 | Кластеризация графа зависимостей | Высокая | Средняя | Нет | Ограниченно | Средняя | Bunch, ACDC, Microservices Identification Tools 9 |
| 4 | Эволюционные и многокритериальные алгоритмы | Полная | Средняя/низкая | Да (при нагрузочном тестировании) | Полная (NSGA-II/III) 20 | Средняя/высокая | Собственные реализации, MOEA Framework, jMetal |
| 5 | Reinforcement Learning (RL) | Полная | Высокая в runtime | Полная (онлайн) | Полная | Очень высокая | Uber Michelangelo, Netflix Conductor, OpenAI Gym + K8s 22 |
| 6 | Гибридные мета-обучаемые (HML-MOO и аналоги) | Полная | Очень высокая (70–90 % ускорение) | Да (офлайн + онлайн) | Полная, с Парето-фронтом | Высокая | Исследования 2024–2025, Alibaba Sigma, внутренние системы Amazon/Google 2 |
Качество микросервисной архитектуры оценивается через комплекс разнородных метрик, которые охватывают операционные, ресурсные, структурные и другие аспекты системы. Согласно систематизации в работе Колесникова и соавторов, метрики классифицируются по шести функциональным группам, что позволяет получить всестороннюю картину 2. Каждая метрика имеет единицы измерения и способы замера с использованием специализированного ПО. Ниже приведены основные группы с примерами метрик и инструментов для их определения, основанными на предоставленном списке из 70 показателей.
Эти параметры отражают поведение системы в реальной эксплуатации, фокусируясь на производительности, доступности и надёжности. Они помогают выявлять проблемы в реальном времени и поддерживать качество обслуживания. Примеры включают время отклика (среднее время ответа на запрос, измеряемое в миллисекундах с помощью Prometheus в комбинации с Grafana, Jaeger или Apache JMeter), пропускную способность (количество запросов в секунду, отслеживаемое Apache JMeter, k6 или Locust), задержку (время от запроса до ответа в миллисекундах, фиксируемое Wireshark, Prometheus или Pingdom), доступность (доля uptime в процентах, мониторируемая UptimeRobot, Grafana Loki или Kubernetes API), надёжность (процент успешных запросов, собираемый Prometheus, Sentry или ELK stack), количество ошибок (отношение неудачных запросов в процентах, анализируемое Prometheus, Grafana или ELK), среднее время между сбоями (MTBF в часах или днях, извлекаемое из Kubernetes events или system logs) и среднее время восстановления (MTTR в минутах или часах, отслеживаемое через Incident Management или Kibana) 16.
Эти показатели оценивают эффективность использования инфраструктуры и экономическую целесообразность, позволяя оптимизировать затраты и масштабирование. К ним относятся утилизация CPU (доля использования процессора в процентах, измеряемая Prometheus node_exporter или Kubernetes metrics), утилизация памяти (объём в МБ или ГБ, фиксируемый Prometheus или cAdvisor), нагрузка на диск (интенсивность I/O в МБ/с, отслеживаемая iostat или node_exporter), нагрузка на сеть (трафик в Мбит/с, анализируемый netstat, iftop или cAdvisor), стоимость эксплуатации (расходы в долларах на месяц, рассчитываемые Cloud Billing API, AWS Cost Explorer или Azure Cost Management) и энергопотребление (расход в Вт или Дж, оцениваемый Cloud Carbon Footprint или Intel Power Gadget) 12.
Они описывают статические свойства архитектуры, включая связанность, модульность и избыточность, помогая выявлять антипаттерны и планировать рефакторинг. Примеры: количество микросервисов (число сервисов в единицах, определяемое Kubernetes API или Service Mesh dashboard), связанность сервисов (среднее число зависимостей в единицах, измеряемое Jaeger, Zipkin или архитектурным графом), коэффициент когезии (степень целостности от 0 до 1, анализируемая static analyzer или анализом зависимостей кода), число межсервисных вызовов (количество взаимодействий в единицах, отслеживаемое OpenTelemetry или Jaeger), сложность зависимостей (длина цепочек в единицах, фиксируемая архитектурным графом), интеграционная сложность (число точек интеграции в единицах, определяемое Service graph) и модульность (индекс от 0 до 1, оцениваемый ArchUnit или NDepend) 6, 7.
Эти параметры оценивают эффективность жизненного цикла, включая скорость доставки, качество кода и тестируемость, выявляя узкие места в разработке. К ним относятся длительность деплоя (время обновления в минутах, логируемое Jenkins или GitLab CI/CD logs), размер контейнера (объём образа в МБ, измеряемый Docker CLI), количество зависимостей (число библиотек в единицах, анализируемое npm audit, pipdeptree или mvn dependency:tree), объём кода (строки кода SLOC, подсчитываемые SonarQube или cloc), покрытие тестами (процент кода под тестами, оцениваемый pytest-cov, Jacoco или NUnit), сложность кода (цикломатическая сложность в единицах, фиксируемая SonarQube или Radon), скорость сборки (время в секундах, из CI/CD logs), скорость доставки (от коммита до деплоя в минутах, логируемая GitLab CI/CD или Jenkins) и обслуживаемость (простота от 0 до 1, оцениваемая SonarQube или экспертно) 5, 24.
Эти показатели фокусируются на уязвимостях, compliance и рисках, помогая прогнозировать угрозы. Примером служит безопасность (score в баллах или единицах, рассчитываемый SonarQube, Snyk или OWASP ZAP), версионная согласованность (число несовместимых версий в единицах, выявляемое Dependabot или Snyk) и доля нарушений SLA (процент отказов, мониторируемый Prometheus alerts или SLA-мониторингом) 5.
Они оценивают взаимодействия, наблюдаемость и адаптивность распределённых систем. Примеры включают интенсивность коммуникации (сообщений в секунду, измеряемую Kafka, RabbitMQ или OpenTelemetry), время согласования данных (задержка в мс/сек, фиксируемая ETL logs или CDC monitoring), уровень изоляции (степень независимости от 0 до 1, оцениваемая экспертно или анализом связей), нагрузку на оркестратор (операций в секунду, из Kubernetes API metrics), эластичность (адаптивность от 0 до 1, анализируемая Prometheus или HPA), количество инцидентов (число аварий в единицах, из Incident Management System), MTTD (время обнаружения в минутах, из ELK или Prometheus alerts) и эффективность балансировки нагрузки (равномерность в процентах, фиксируемая Kubernetes Ingress или Envoy stats) 8, 12.
В целом, эти метрики собираются с помощью открытого ПО вроде Prometheus для мониторинга, Jaeger для трассировки, SonarQube для анализа кода и ELK stack для логирования. В 2025 году тенденция — интеграция в unified observability-платформы, такие как Grafana или OpenTelemetry, для корреляции данных и автоматизированного расчёта. Выбор инструмента зависит от стека (Kubernetes, Istio) и типа метрики: runtime-метрики требуют реального времени, структурные — статического анализа 16, 26.
Предлагаемый целостный (интегральный) критерий позволяет количественно оценить качество микросервисной архитектуры, объединяя десятки разнородных метрик в единый агрегированный показатель. Он устраняет основные недостатки традиционных подходов — фрагментарность изолированных метрик и субъективность экспертных оценок — и даёт объективную, воспроизводимую характеристику эффективности системы 1.
Критерий строится в три этапа:
Все метрики разделены на шесть групп: операционные, ресурсные, структурные, метрики разработки и сопровождения, безопасности и соответствия, а также специфические метрики микросервисной экосистемы. В общей сложности используется до 70 измеряемых параметров (от времени отклика и стоимости эксплуатации до коэффициента когезии и уровня изоляции сервисов) 2.
Каждая метрика приводится к безразмерному виду в диапазоне \(0; 1\), где 1 — лучшее возможное значение, 0 — худшее.
Для метрик минимизации (latency, error rate, cost, coupling и т.д.): \[ n_{i} = \frac{x_{i}^{\max} - x_{i}}{x_{i}^{\max} - x_{i}^{\min}} \tag{1} \]
Для метрик максимизации (availability, cohesion, test coverage и т.д.): \[ n_{i} = \frac{x_{i} - x_{i}^{\min}}{x_{i}^{\max} - x_{i}^{\min}} \tag{2} \]
Граничные значения \(x_{i}^{\min}\) и \(x_{i}^{\max}\) определяются из SLA, исторических данных или отраслевых бенчмарков 20.
Вводятся весовые коэффициенты \(w_{i} \geq 0\), \(\sum_{i=1}^{n} w_{i} = 1\), отражающие приоритеты конкретного проекта. Итоговый интегральный критерий качества \(K\) вычисляется по аддитивной модели: \[ K = \sum_{i=1}^{n} w_{i} \times n_{i} \tag{3} \] где \(K \in 0; 1\)
Чем выше \(K\), тем лучше архитектура при заданных условиях эксплуатации 1.
Таким образом, критерий превращает многомерную задача оценки микросервисной архитектуры в одномерную скалярную оптимизацию, сохраняя при этом всю необходимую детализацию и гибкость настройки под конкретный бизнес-контекст 1, 2.
В ходе исследования были проанализированы современные подходы к проектированию, оценке и оптимизации микросервисных архитектур, что позволило выявить их ключевые преимущества и ограничения. Установлено, что при всей гибкости и масштабируемости микросервисного подхода его эффективность существенно зависит от качества архитектурных решений, согласованности сервисов, уровня наблюдаемости и корректного управления эксплуатационными метриками 8, 11.
Проведённый обзор существующих методов оптимизации показал, что традиционные экспертные и статические подходы в большинстве случаев оказываются недостаточными для сложных распределённых систем. Наибольшую результативность демонстрируют эволюционные и многокритериальные алгоритмы, методы машинного обучения и гибридные мета-оптимизаторы, обеспечивающие адаптацию к динамическим нагрузкам и возможность комплексной оценки архитектуры 20, 21, 22.
Разработанный в работе целостный интегральный критерий качества микросервисной архитектуры позволяет объективно сравнивать различные конфигурации системы, учитывая десятки разнородных метрик — от производительности и надёжности до структурных характеристик и качества разработки. Использование нормализации и взвешенного агрегирования делает критерий гибким и применимым к различным проектам 1, 2.
Создание информационной системы, реализующей сбор метрик, расчёт интегрального показателя и автоматическую оптимизацию архитектуры, обеспечивает возможность системного анализа качества микросервисной системы и поиска её наиболее эффективной конфигурации. Такой подход структурирует процесс принятия инженерных решений, снижает вероятность архитектурной деградации и обеспечивает повышение устойчивости, адаптивности и производительности программного комплекса 2.
Таким образом, результаты исследования подтверждают актуальность и практическую значимость предложенной методики. Разработанный интегральный критерий и подход к оптимизации могут использоваться как самостоятельный инструмент анализа архитектуры, так и основа для дальнейших исследований, направленных на повышение эффективности современных распределённых систем 1, 30.